# RP 项目运行说明:从用户输入到世界书、状态与记忆
从“我把铜钥匙递给北塔守卫,请他开门”开始,沿着真实代码看:谁先处理、模型拿到什么、工具做了什么、结果保存在哪,以及什么时候影响回复。
- **本轮怎么说话**:业务先选场景,Harness 准备角色和资料,再由 Actor 或前台工具循环交付正文;已有 Workflow 需要显式接入。
- **故事怎么延续**:普通 Agentic 每个逻辑轮从开轮材料分析,尝试保存后续可读状态;Story、日记、表格和 Compact 各有自己的触发、输入和保存规则。
- **世界书怎么参与**:作者发布资料、服务端绑定版本,服务按本轮条件选条目,Harness 把入选正文加入 Actor。当前后台 Planner 没有自动收到同批世界书原文。
本文按业务过程分为 19 章,每章可以独立阅读。第 2 章看一次请求,第 7 章对照上下文,第 11–13 章回答世界书怎么选、注入什么、谁控制,第 19 章把两轮对话串起来。示例对话是解释用的虚构内容,流程和限制以代码为依据。
代码依据固定在 Harness `80aef3fa5582d8508ecdd1afa206391940ce9502` 与 Worldbook Service `3a11e333afd335aeff165e0ccc3654af8e1897d1`。正文解释仓库实现与默认配置;部署配置、外部服务内部算法和线上运行结果不据此推定。代码链接在网页版各章末尾可展开。
## 1. 项目全貌:两个仓库分别负责哪一段
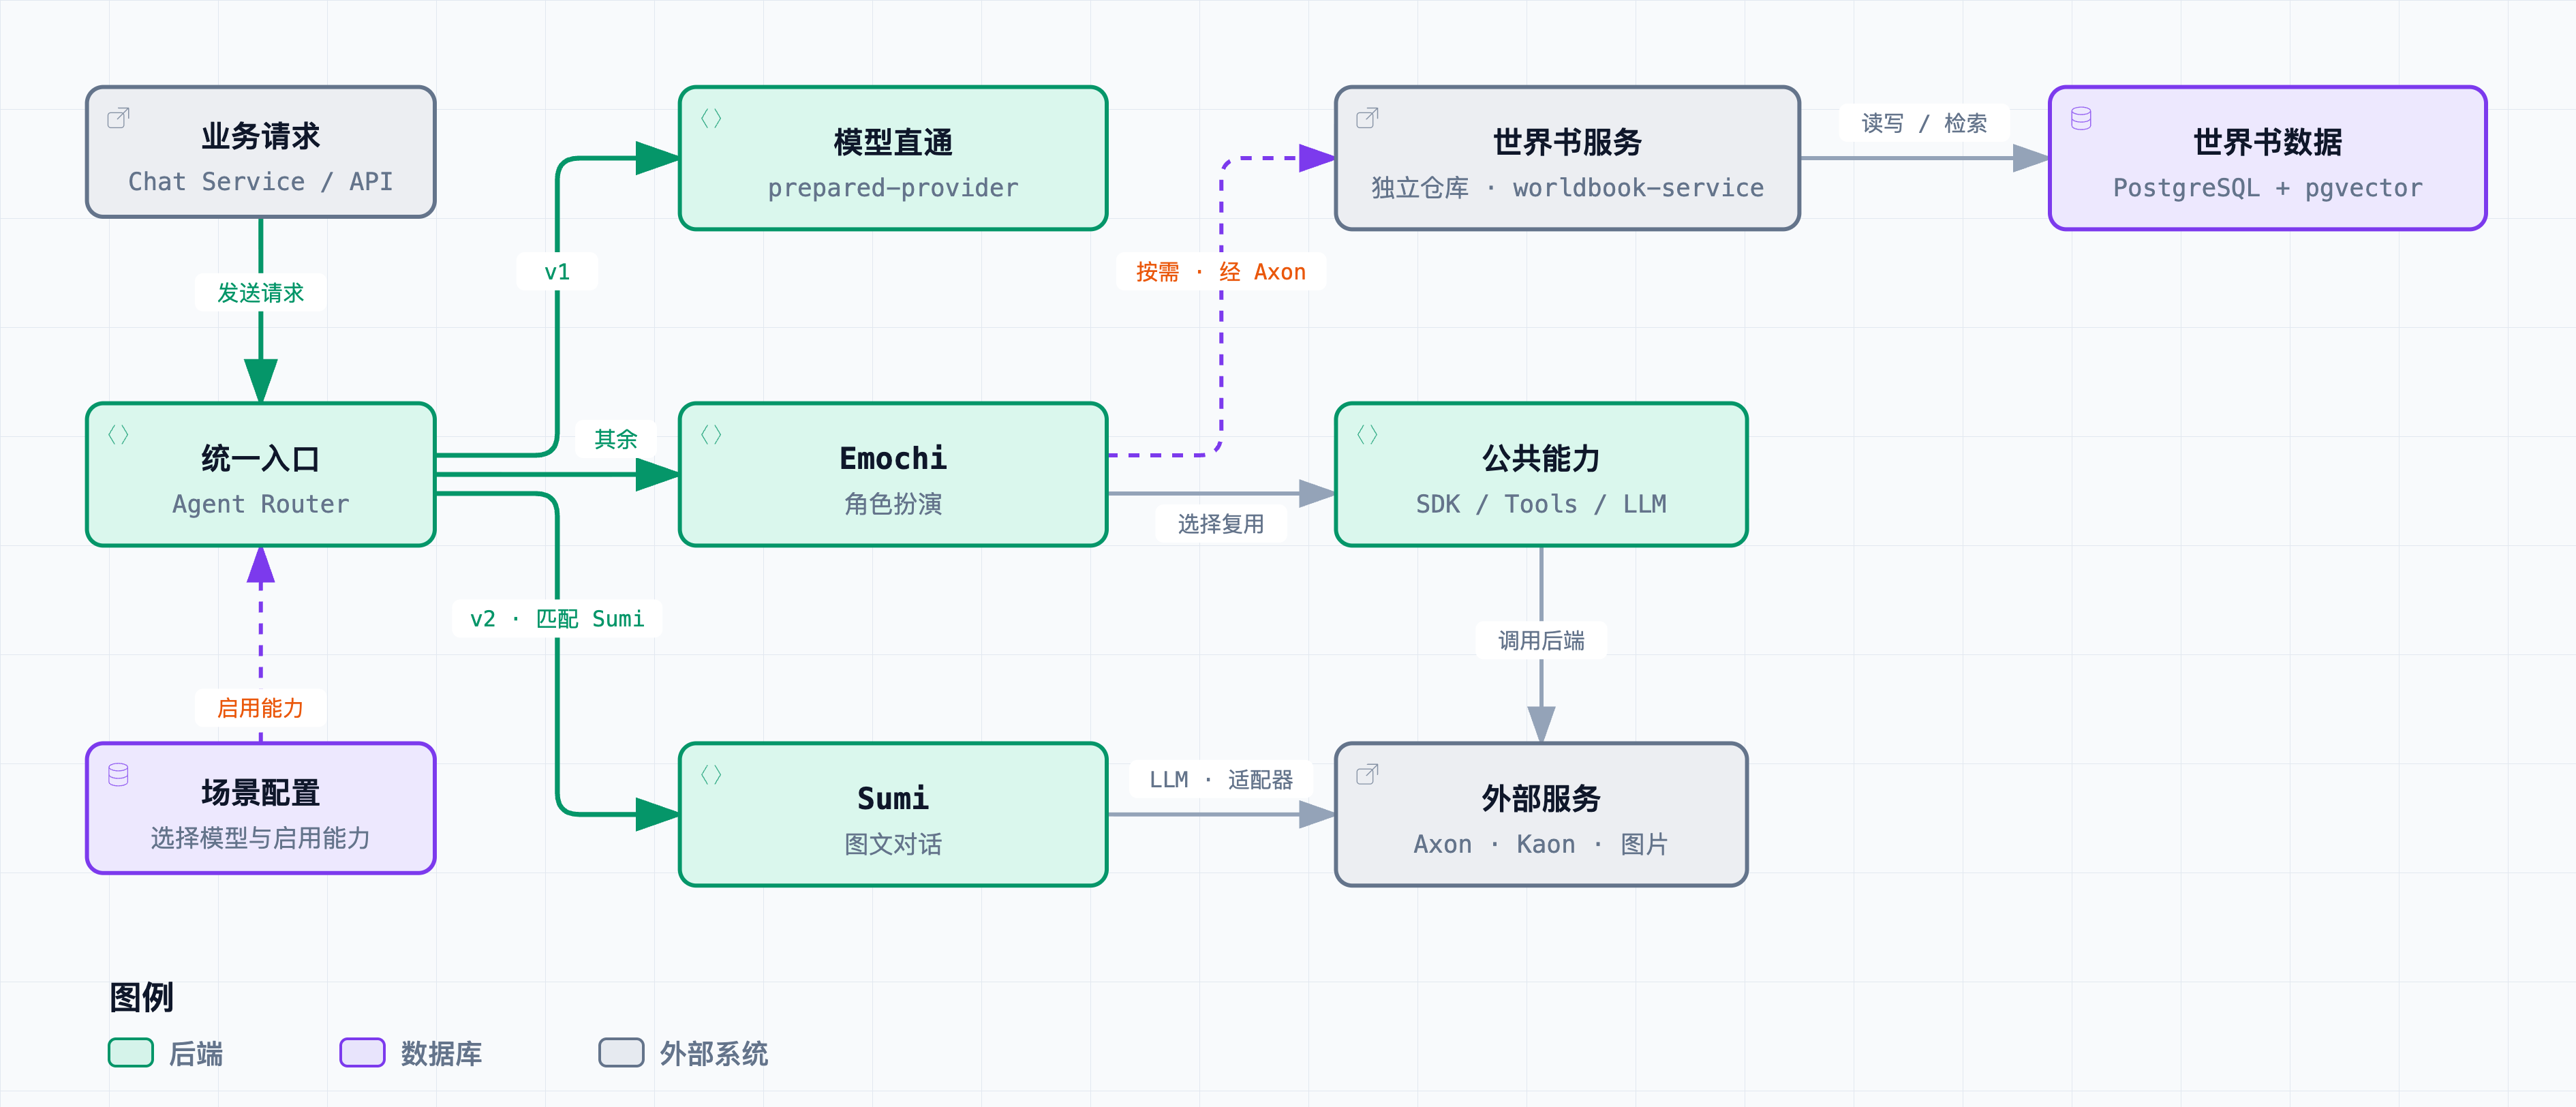
**整个项目做的是:为角色准备资料,组织模型和工具完成一轮演出,再把需要延续的信息保存下来。** 世界书服务负责资料,Harness 仓库同时包含通用执行组件和已经接好业务的应用。
### 把系统里的角色认清
| 名称 | 通俗理解 | 负责什么 |
| --- | --- | --- |
| Actor / Writer | 对用户演戏的角色演员 | 根据本轮材料写正文 |
| 前台控制器 | 组织这次交付的现场调度 | 在启用的场景中安排 Actor、图片、长期指令等工具 |
| Orchestrator | 后台分析的协调者 | 判断需不需要专家,选择工具,必要时请 Director 汇总 |
| 六类专家 | 剧情、人物、知识、世界、伏笔、镜头顾问 | 各自分析同一轮起点的材料,提出建议 |
| Director | 整理持续工作笔记的角色 | 生成完整候选状态,再交程序校验与保存 |
| Worldbook Service | 作者设定资料库 | 保存书与版本,按规则和相关性选出本轮条目 |
| Axon 等业务服务 | 数据和公司服务的连接层 | 提供角色、模板、记忆、状态及世界书等接口 |
“Planner”在聊天里容易泛指所有规划者。下面会明确写前台控制器、后台协调器或 Story 编排,避免把它们当成一个共享所有材料的模型。目录中的 `StaticPlanner` 又是另一回事:它检查给定执行图,不负责理解 query 后自动挑选产品模式。
### 两个仓库里放了什么
Harness 的 **SDK 包**提供通用 Agent 循环、独立慢执行、快慢组合、工具注册、任务与观测组件;**Core Tools 包**提供专家、记忆、Story 和图片工具。业务可以只使用其中一部分。
同一仓库的 **Emochi 应用**把角色模板、Actor、Agentic、记忆、Story、世界书等接到真实服务;**Sumi 应用**有自己的图文协议和图片交付流程。安装 SDK 不会自动启动这些应用,也不会自动连接公司的线上配置。
Worldbook Service 是另一个服务:接收导入文件或原生条目,在 PostgreSQL 保存原文和不可变版本,按需要建立向量索引,提供搜索与上下文选择。它不负责生成角色回复,也不在选条目时把剧情推进到下一幕。
### 一份内容分别由谁保存
用户与角色说过的话属于聊天记录;普通 Agentic 有自己的持续文本状态和专家记录;Story 有世界与叙事快照;日记、表格走选定的记忆后端;Compact 保存压缩检查点;世界书保存作者内容版本。它们可以互相提供材料,但不会自动合并成一个“总记忆”。
贯穿本文的虚构例子是:**用户拿着铜钥匙来到北塔,向守卫请求开门。** “铜钥匙代表旧王室”是作者设定;“钥匙现在在谁手里”是当前状态;“昨天借钥匙的约定”是经历;“之后可以核验身份”是计划。后面的每个模块都围绕这四类信息解释。
依据:[仓库与包边界](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/README.md#L3)、[接入架构](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/docs/sdk/architecture.md#L9)、[应用装配](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/adapters/agent-router/dispatch.ts#L1125)、[世界书服务接口](https://github.com/FlowGPT/worldbook-service/blob/3a11e333afd335aeff165e0ccc3654af8e1897d1/src/worldbook/app.py#L190)。
## 2. 用户这一句话,完整走过哪些步骤
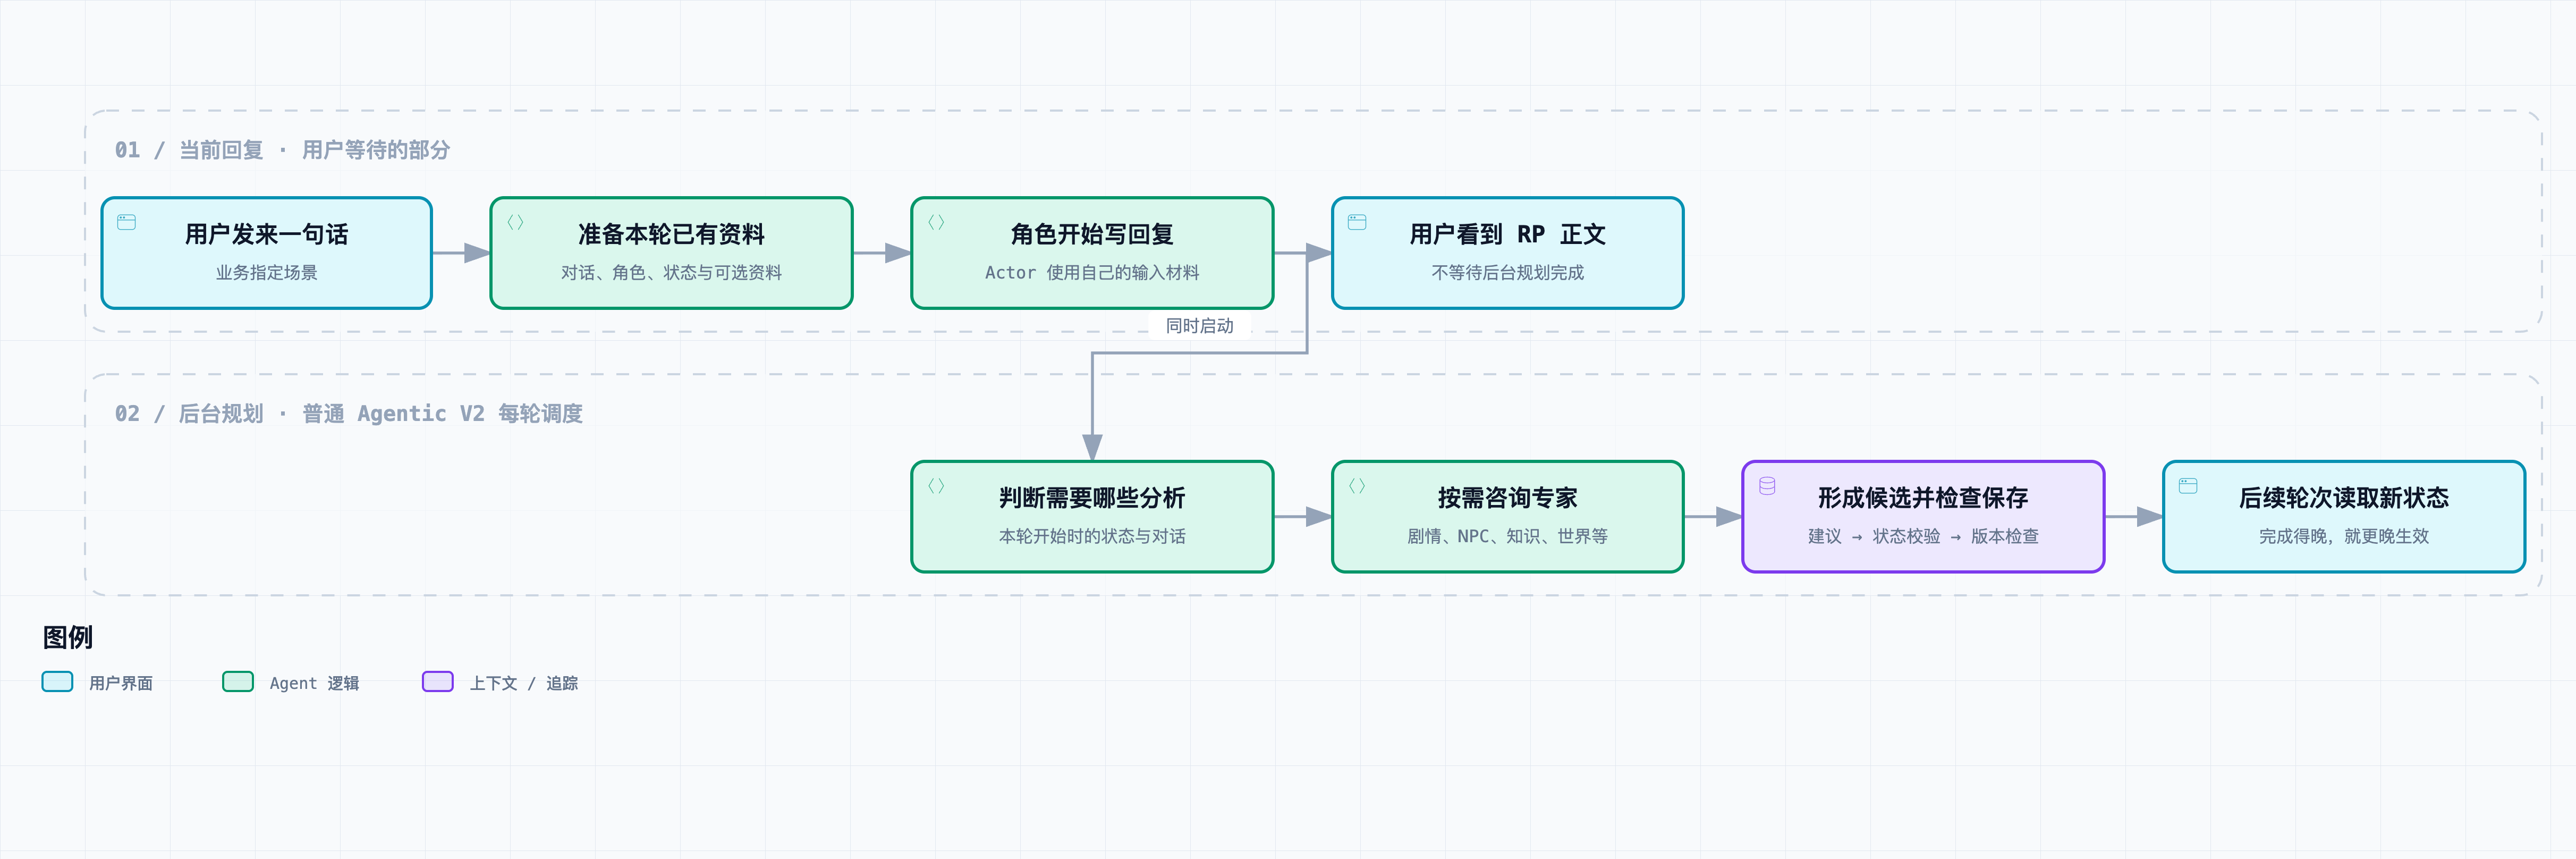
先用一个贯穿例子:用户说,**“我把铜钥匙递给北塔守卫,请他开门。”** 北塔、守卫、钥匙都是示意素材;下面描述的是当前代码怎样处理这句话。
### 入口确认场景
**入口先确定使用哪套业务。** 请求带着 `scenario_id`,程序据此读取场景配置;没有一个总调度模型先读这句话,再自动判断“该走单模型、Workflow,还是慢系统”。接入还有两种分工:预组装模式由 chat-service 把模型消息准备好再交给 Harness;closed-loop 模式把角色、历史、问题等材料交进来,由 Harness 调用 Axon 的配置和 PromptManager 完成组装。下面沿 closed-loop 往下看。[两种接入的分流](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/adapters/agent-router/dispatch.ts#L1256)
场景也不是任意功能叠加。普通 Actor 可以搭配普通 Agentic V2,也可以再配前台工具循环;Story 使用另一套剧情准备和提交逻辑。当前世界书专用场景必须启用 Agentic V2,同时禁止 Story、Sumi 和前台工具循环。因此,不能把所有模块画成“每次依次经过的流水线”。[组合约束](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/server.ts#L715)
### 正文之前准备两份材料
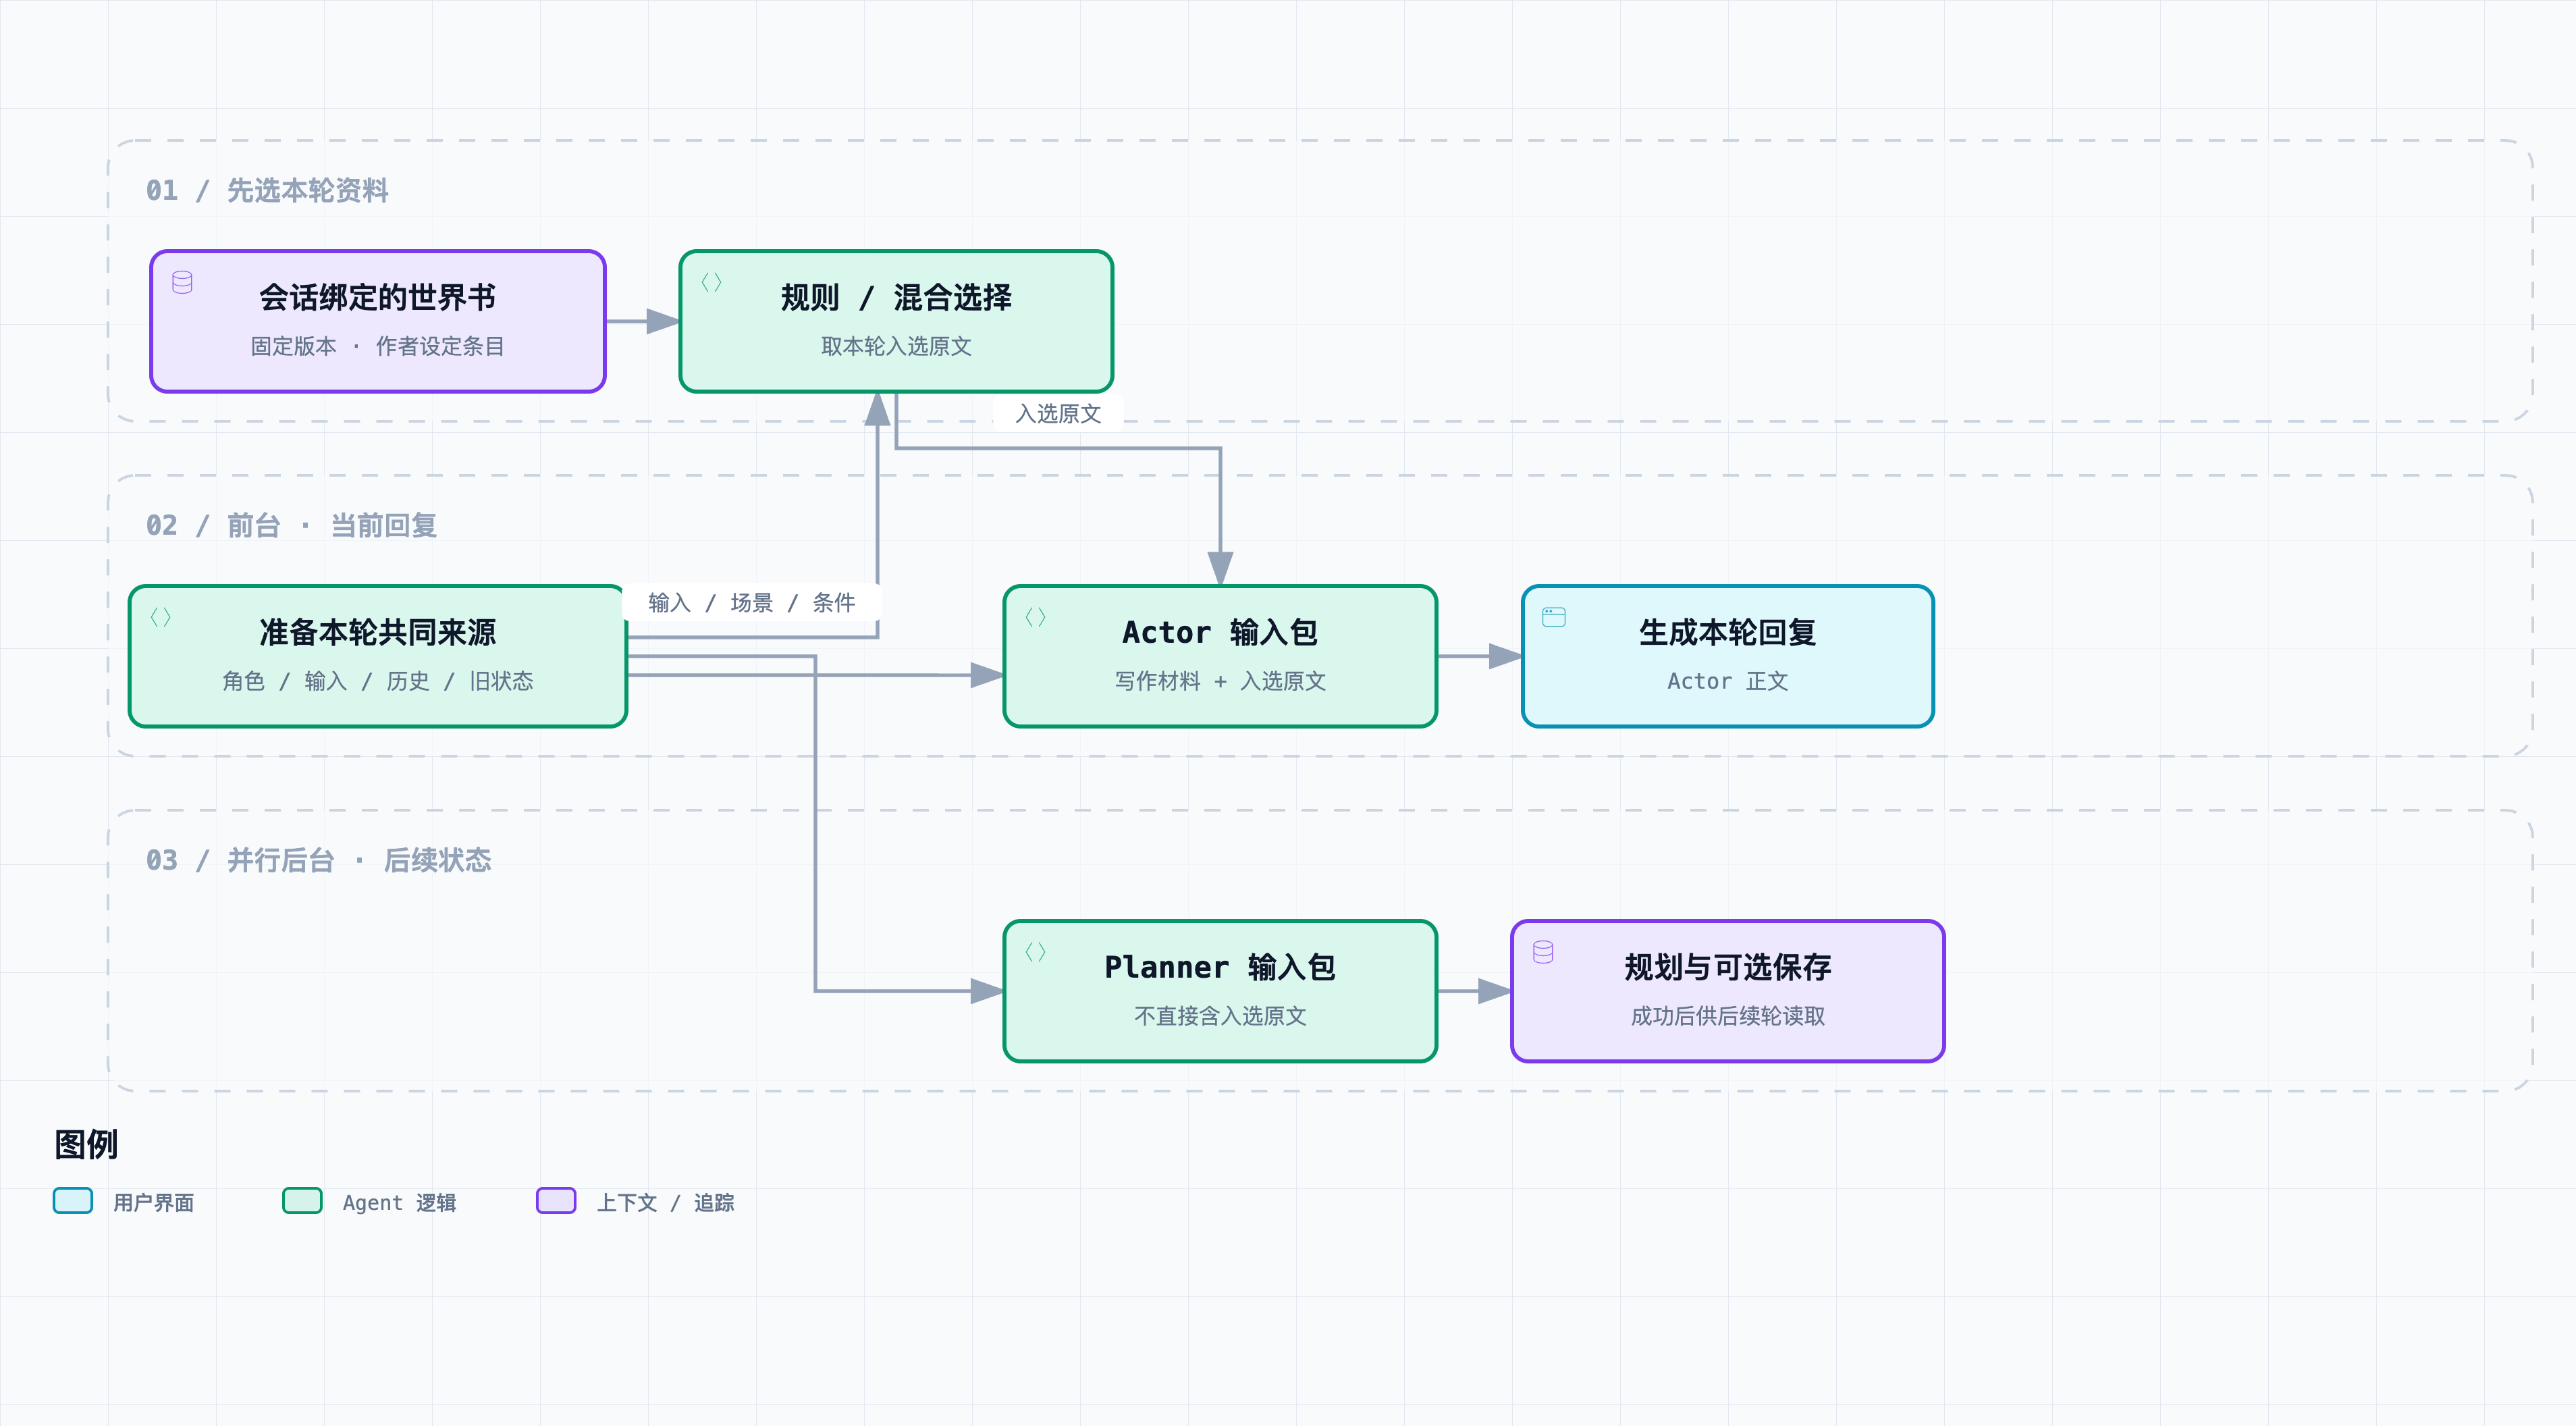
**准备材料发生在正文之前。** 开启记忆的场景先召回记忆;准备过程还会读取已保存的剧情状态,再按所选路径组织 Actor 的角色设定、用户人设、历史和问题。世界书路径先用开轮状态中的公开场景、当前问题和近期历史完成条目选择,再参与 Actor 消息的渲染、装配与预算检查。当前仓库的 `agentic-v2-worldbook` 配置是 `memorySources=[]`、没有 Compact,所以不能替它补上一条“每轮先读取日记和摘要”的链路。[世界书场景配置](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/config/scenarios/agentic-v2-worldbook.json#L1)
这时产生两份不同的输入包:
- **Actor 包**:角色与表达规则、渲染后的历史、用户这句话、旧剧情状态,以及本轮选中的世界书条目。例如选中“铜钥匙不能代替开门所需的摄政官手令”。
- **后台 Planner 包**:角色资料、用户这句话、开轮历史、旧剧情状态及各规划模型的说明。它没有直接收到同一批世界书条目,也没有直接拿到同一批日记、表格内容。
后台模型用的近期对话段、状态投影还有各自长度限制,不能把“两份包来自同一轮”理解为“两个模型看见完全相同的材料”。准备阶段还会读取后台提示词配置;只有准备成功、进入生成,才启动正文与后台规划的并行工作。[材料准备与两份上下文](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/runtime.ts#L338)
### 正文之后分别收尾
**正文完成以后还有收尾。** Harness 会等待 `memory.ingest` 返回,但它可能只是安排记忆处理:Axon Go 日记走调度;表格有后台 runner 时安排后返回,没有 runner 时才等待表格处理。日记是否达到生成阈值,也由另一套记忆机制决定。聊天正文的保存仍由宿主完成;后台剧情状态另走自己的提交。因此,一次请求里“用户看见文字”“聊天记录保存”“记忆更新”“剧情状态更新”有各自的完成时刻。[记忆收尾的真实分支](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/memory/axon-memory-runtime.ts#L151)
## 3. 路由与组合:这一轮到底启用哪套流程
**请求先选定业务场景,场景再决定执行哪套流程。当前没有一个通用模型先判断 query 复杂度,然后自动把任务分到快、慢通道。**
### 场景从哪里来
服务启动时加载启用的 scenario 配置。请求携带 `scenario_id`,入口查到对应设置,再选择 Actor、记忆后端、Agentic、Story、世界书等实现。场景文件描述的是已有业务链路的配置;它本身不会生成新工具,也不会自动发现一份用户已有的 Workflow。
启动环境中的旧 JSON 配置还可能整条覆盖同名场景。因此,文件里写着某个模型或预算,并不保证运行时最终使用的就是它;有效配置以服务实际加载结果为准。
### 仓库里实际存在的组合
| 产品模式 | 用户发一句话后发生什么 | 这套模式的特点 |
| --- | --- | --- |
| 普通 Actor | 准备角色与对话材料,生成正文,执行相应后处理 | 可以没有后台 Agentic |
| Actor + 普通 Agentic | Actor 写正文,同时后台按需分析并尝试保存状态 | 后台使用开轮材料,结果供后续读取 |
| 世界书 + 普通 Agentic | 先选世界书,装进 Actor,再正文与后台并行 | 当前专用场景不与 Story、Sumi、前台控制器共用 |
| Actor + Compact | 准备时按预算检查历史,必要时压缩,再写正文 | 压缩会影响本轮首字前的准备 |
| Agentic + Compact | 快慢都可结合摘要,但由治理模式决定 | enforce 才让后台采用摘要和保留历史;shadow 仍用原历史规划 |
| 前台工具循环 + 普通 Agentic | 前台调度文字/图片/长期指令;后台另做持续规划 | 两个控制循环各有输入和工具名单 |
| Story V1 | 核对上轮采用的正文,准备世界与剧情,生成本轮并保存待复核记录 | 替换普通 Agentic 后台分支 |
| Sumi | 走独立图文生成、状态与图片交付流程 | 不自动继承普通 Emochi 的全部模块 |
世界书当前场景文件设定 `memorySources=[]`,也没有 Compact;因此分析这个具体场景时,不能再画上“每轮日记召回、自动压缩”两步。通用 Agentic 可以采用其他配置,但那是另一条实际接线。
### 同一句话为何可能走不同路径
“我递上铜钥匙”在世界书场景里会触发资料选择;在 Story 场景里可能被解析成当前世界行动;在普通 Actor 场景里则直接作为角色对话材料。决定差异的是业务选择的模式。系统没有因为这句话同时提到物品与地点,就自动把三套模式全部运行。
配置中的 `routingMode=manual` 也不是要求人来选专家。两种模式都由模型选工具;manual 关闭的是后台协调模型的自动升级。auto 可以在达到工具调用数量阈值等条件时换模型重新选择。
依据:[请求选场景](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/adapters/agent-router/dispatch.ts#L289)、[场景加载与覆盖](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/scenario-files.ts#L21)、[组合限制](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/server.ts#L715)、[世界书具体配置](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/config/scenarios/agentic-v2-worldbook.json#L1)、[协调模型升级](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/agentic-v2.ts#L803)。
## 4. 快通道:单模型、Workflow与前台工具循环
**快通道负责交付这次用户可见的回复,里面也可能有多次调用。** “快”是职责和等待关系,不保证只调用一个模型,也不保证耗时短。
### 单模型与现成 Workflow
最简单的接法是一个模型节点:把这一轮准备好的消息发给模型,得到文本。SDK 的默认 `SimpleFastRuntime` 就是一次 `model.complete`;它也允许调用方替换整个 fast runtime。因此接入方可以把已有 Workflow 包进去,但需要自己提供这套执行实现,SDK 不会因为检测到“有 Workflow”就自动切换。默认实现的 `stream` 也是先完成调用再产出内容,不能据此承诺默认具备逐 token 输出。[SDK 默认快运行时与替换入口](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/sdk/src/runtime.ts#L11)
Emochi 还保留了执行图能力:`StaticPlanner` 校验并排序配置好的节点依赖,随后按图执行。它处理的是“已配置的哪些步骤先后运行”,不理解铜钥匙问题,也不负责把请求分成快慢两边。[静态执行图的工作范围](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/static-planner.ts#L4) 当前 closed-loop dispatch 实际构造的是空执行图,所以解释现有业务时,主路径应落在 Actor 与可选前台循环上,不能凭通用图能力补出一条正在运行的复杂 Workflow。[当前应用的空执行图](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/adapters/agent-router/dispatch.ts#L719)
### 前台模型怎样调度工具
**启用 `preActorDirector` 时,这次回复由一个前台控制模型编排。** 它最初收到“怎样调用工具”的控制说明和用户原话,并没有直接拿 Actor 整份角色、历史和状态消息。它调用 `actor` 后,正文模型才使用完整 Actor 包生成文字;返回的文字与 token 用量再交给控制模型,让它决定续写、安排图片、提交 DIO 或结束。
例如,在允许前台循环的场景里:控制模型先调用 Actor,写“守卫接过钥匙,转向侧门”;如果使用 `visual_beat` 且产生可用片段,程序会自动安排这一幕的图片,再让控制模型判断是否继续写“锁芯发出轻响”。续段把已经写出的文字加入 Actor 对话,所有段共用整轮输出 token 预算。循环最多 12 步,有 DIO 能力时 13 步,`over` 前必须调用过 Actor;没有得到有效 Actor 结果时会回落普通生成。[前台输入、工具与整轮预算](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/actor/roleplay-runtime.ts#L329)
### 图片和长期指令怎样交付
这里的图片和 DIO 有不同后果。图片先留占位,独立任务完成后可以补进**当前这条**助手消息;所以“后台完成”不等于“只能影响下一轮”。DIO 面向明确要求持久修改设定的输入,例如“以后这把钥匙都归守卫保管”,前台只等待任务被接收,每轮至多成功接收一次;完成后的设置供后续轮加载,不会改掉本轮已准备好的 Actor 包。它们也不会自动转交普通 Agentic 的六位专家或 Director。普通前台循环可以与普通 Agentic 并存,但上一章的世界书专用场景禁止这种组合。[DIO 与图片的独立调度](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/adapters/agent-router/dispatch.ts#L938)
## 5. 慢通道:协调器、六位专家和Director怎样工作
**普通 Agentic V2 每个成功进入生成的逻辑轮都会安排一次后台规划,没有“累计 X 轮才启动”的全局开关。** 它先启动协调器 Orchestrator,再看是否需要专家。普通闲聊也会先调用协调器,只是它可以返回“不调用工具”,保持旧状态。同轮 Actor 重试或分段续写不会重复安排这一任务。日记阈值、最近几条历史、规划跨度都不是这里的启动周期。[每轮一次的调度与正文并行](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/runtime.ts#L558)
### 六位专家分别分析什么
协调器拿开轮材料作判断。对铜钥匙例子,它可以认为“新人物出场,需要查人物关系;钥匙涉及承诺,需要查伏笔”,然后输出结构化工具调用。六位专家各自是一次分析模型调用,共同收到角色资料、开场白、用户人设、状态投影、近期对话、当前问题,以及协调器给出的调用原因和关注点;区别在于专业任务和分析结果:
| 专家 | 要检查什么 | 铜钥匙例子的可能输出,均为示意 |
|---|---|---|
| `analyze_plot` 剧情 | 当前进展、可行方向与分支 | “交钥匙可推动信任,但不要把请求直接写成开门成功。” |
| `judge_npc` 人物 | 身份、动机、位置、关系是否连续 | “守卫在门外执勤;谨慎核验钥匙符合其职责。” |
| `audit_knowledge` 知识 | 谁知道哪件事、从何得知 | “守卫尚未获知钥匙来历,不能直接说出用户的秘密。” |
| `simulate_world` 世界 | 时间和场外活动怎样继续 | “若已有巡逻线索,可考虑队伍接近,但不要无依据跳时。” |
| `manage_callbacks` 连续性 | 伏笔、承诺、物品和伤情 | “钥匙曾被要求归还,保留归还约定与归属待确认项。” |
| `direct_scene` 场面 | 镜头、节奏和角色自主性 | “聚焦守卫验钥匙的反应,把是否跟进留给用户。” |
这些工具都提供建议,不直接保存剧情状态;专家也不会各自再开一个无限工具循环。它们没有直接得到本轮入选的世界书原文,因此不能说知识专家已经核验了“铜钥匙不能代替手令”这一条,除非这条信息本来就在它可见的历史或状态里。[六类专家及输入构造](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/tools/src/modules/memory/advisory.ts#L18)
### 哪些情况程序会强制调用
**模型选择之外还有程序硬规则。** 对应工具启用时,首轮强制加入人物审计和场面指导;近期可见对话与当前问题中,如果姓名识别规则发现旧状态里没有的新名字,会强制人物审计。这是有限的名称检测,不是对所有新人物的完备理解。发生这类必需审计、且状态工具启用时,第二阶段还会强制要求 Director 更新,避免协调器把审计结果看完就丢弃。[首轮、新人物的必需审计](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/agentic-v2.ts#L638)
### 协调、并行咨询与导演汇总
执行顺序是:**协调器选工具 → 一批专家并行 → 协调器复核结果 → 可选 Director**。没有专家时也允许直接选择 Director;没有硬规则约束的续聊,可以不选它。Director 是另一次模型调用,收到旧状态和专家结果,产出完整的候选状态文本;它不写用户正文,也不把建议实时塞回正在说话的 Actor。[两阶段协调与 Director 选择](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/agentic-v2.ts#L803)
### 调用限制和模型升级
默认配置是 `maxToolCalls=7`、`maxParallelTools=6`、状态上限 8000 字符、单次模型调用超时 180 秒;第一批执行上限取两个工具限制的较小值。这不是整轮最多 7 次模型请求:协调器复核、重试等另有调用。`routingMode=manual` 也不需要人工点选,它表示不自动升级到另一模型;`auto` 在配置了升级模型、工具数达到阈值时可以重做路由,默认阈值为 3。两者都由模型输出工具选择、程序执行。[默认限制与路由配置](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/agentic-v2.ts#L208)
## 6. 后台状态如何真正影响后续回复
把普通 Agentic 的持续状态看成“下一次准备回复时可读的剧情工作笔记”。它记录场景、人物、知识边界、伏笔和后续方向;Director 交的是**整份替换文本**,当前应用没有独立的 `contextPatch` 合并协议。
### 从旧状态到新状态的一轮
铜钥匙这轮可以按下面的时间线理解:
1. 开轮读取版本 12:用户持有钥匙,守卫仍在门前。Actor 和后台都以这个时间点为依据。
2. Actor 正在生成“守卫接过钥匙”;后台只能看到用户“递钥匙”的请求,不能读到正在生成的这句话。因此,后台不得靠本轮 Actor 成功状态把“已经接过”当作已核实结果。
3. Director 可能形成候选:“用户正尝试交出钥匙;保管归属待对话确认;保持守卫的谨慎态度。”程序检查格式、长度、禁用标记及是否发生变化,再尝试保存。
4. 如果保存为版本 13,后续请求准备时读到它,才会把这份指导加入 Actor。若下一条消息来得更早、仍读到版本 12,就要更晚才生效;当前正在生成的正文不会被热更新。
### 版本冲突时怎样处理
提交使用 **CAS:只有服务器当前版本仍等于我开轮读到的版本,才接受替换**。两轮后台同时工作时,较晚提交的旧版本候选会得到冲突,不能覆盖别人已保存的新版本;当前规划随即结束,不会自动拿新版重新规划。格式无效、内容没变、未选 Director、失败,都可能没有新版本,所以“专家跑完”不等于“状态已经更新”。[候选校验与版本提交](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/agentic-v2.ts#L935)
### 专家记录怎样进入下一轮
成功专家的分析还可以随这次有效提交进入 `ledger`。这里面可能是建议、推测和未来方向,不能一律视为故事里已发生的事实;程序检查文本格式也不等于机械证明事实正确。后续构造模型输入时,会把状态与部分有效 ledger 编译成文本,并裁剪长度:Actor 默认最多 10000 字符,后台模型的状态段最多 6500 字符;ledger 按类别取有限的近期记录,状态太长还会挤掉后面的记录。这是文本投影,不是每个模型获得完整数据库,更不是按“隐藏事实”字段做强制隔离。[状态与 ledger 如何投影](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/tools/src/modules/memory/advisory.ts#L192)
### 重试和取消
后台失败通常留下旧状态;默认模型调用最多再试两次。保存请求如果结果不明确,重试遇冲突时会读回核对版本、消息 ID 和内容,确认是否其实已经保存成功;正常的竞争冲突不会反复覆盖。[重试与保存结果核对](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/agentic-v2.ts#L102)
**取消正文不自动撤销已经启动的普通 Agentic。** 当前 Emochi 调度没有绑定 Actor 的取消信号;用户停止生成后,后台仍可能完成并尝试 CAS,是否提交成功还取决于版本检查。这也意味着它不是“看到已保存正文才更新”的机制。这个行为属于 Emochi 包装层,不能当作所有 SDK 接入的统一保证。[后台独立信号](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/runtime.ts#L571)、[Actor 取消后的测试断言](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/test/agentic-v2.test.ts#L1922)
## 7. 上下文组装:每个模型实际拿到哪份材料
**上下文就是这一次调用真正发给模型看的材料。程序读取了数据,并不等于每个模型都收到了它。**
### 原有接入与 Harness 闭环,组装工作放在哪里
预组装入口由 chat-service 准备 messages,Harness 接收并调用模型;相应日记、表格前后处理仍归 chat-service。闭环入口则由 Harness 协同 Axon 读取角色、模板、配置、历史与记忆,构造模板变量,再渲染和检查预算。后者接管了更多准备工作。
闭环中的典型材料是:角色卡与开场白、用户 Persona、最新问题、历史窗口、模板引用的记忆变量,以及已启用的状态或世界书。模板决定变量放在哪;预算处理决定保留多少。正文真正使用的是准备后的 Actor 消息,不应把另一个通用 Prompt 编译器生成过的所有块都假定再追加一次。
### 三类模型分别看什么
| 材料 | Actor 正文模型 | 前台控制器(若启用) | 普通 Agentic 后台 |
| --- | --- | --- | --- |
| 人设与任务 | 写作用角色模板、人设、示例 | 当前控制说明与可用工具;不等于整份 Actor 人设 | 单独组织的角色定义、分析说明 |
| 最新 query | 在对话/模板中使用 | 作为本轮要完成的请求 | 单独列为最新用户输入 |
| 已有历史 | 经模板窗口、整理及预算处理 | 根据前台循环自己的请求组织 | 默认用原请求历史组织近期 transcript |
| 已保存 Agentic 状态 | 转成写作用系统材料 | 不自动等于后台状态包 | 同一开轮快照的分析投影 |
| 世界书入选正文 | 世界书场景直接加入 | 当前世界书场景与该控制器互斥 | 没有自动加入同批正文 |
| 日记/表格召回 | 模板引用变量后才进入 | 不自动收到全部召回材料 | 没有直接复制同批 memory.items |
| 本轮 Actor 已写出的段落 | 分段续写可以使用 | Actor 工具结果会返回控制器 | 并行规划看不到 |
| 本轮新专家建议 | 不会中途自动改写当前正文 | 不自动共享后台结果 | 后台内部供协调和 Director 使用 |
### “同一份状态”也会被裁成不同的材料
普通 Agentic 的 Actor 状态投影上限为 `maxStateChars + 2000`,默认 10000 字符;后台相关模型的投影上限为 6500 字符。它们是这一部分文本的字符上限,不是整个请求的 token 预算。
状态后附的专家记录先取有效记录窗口,再按类型限制条数与每条长度,最后还要一起截断。内置后台近期 transcript 取最后 9 条非空 user/assistant 消息,不是 9 轮;可配置模板若另引用历史宏,实际输入还可能包含更多历史信息。
普通状态投影主要做文本长度和窗口处理,没有 Story 那种按 POV 可见范围组织字段的同等机制。“写了秘密”与“秘密不会进入角色模型”不能直接画等号。
### 对北塔例子的实际影响
Actor 读到了世界书“铜钥匙不能代替手令”,可以据此拒绝放行。后台若没有从人设、旧状态或历史中读到同样规则,就没有收到这项判断依据。即使后台调用了知识专家,也不能说它已经核对这条世界书。
若 Actor 把门禁规则说进最终保存的对话,未来后台在历史窗口内看到这段话,才可能间接获知;Actor 只是默默参考、没有说出的其他设定不会自动传过去。
依据:[预组装与闭环入口](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/adapters/agent-router/dispatch.ts#L1244)、[模板变量构造](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/integrations/roleplay-axon-adapter.ts#L369)、[后台材料构造](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/runtime.ts#L402)、[状态投影](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/tools/src/context-compiler.ts#L32)、[前台收到 Actor 工具结果](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/actor/roleplay-runtime.ts#L666)。
## 8. 记忆:日记、表格、用户偏好与历史压缩
假设用户昨天向莉娅借了钥匙,今天说“用昨天那把钥匙开门”。要让角色接得上,系统可以读最近聊天、较早对话的压缩摘要、日记摘要或记忆表。这些材料各有来源,不是一个叫 Memory 的模块自动包办。工具包里放在 `memory` 目录的六个专家,实际负责分析剧情、NPC、知识、世界变化、伏笔与镜头;它们读取角色、状态和近期对话,返回建议文字,不自己保存长期记忆。例如专家可以提醒“钥匙还没归还”,但这条建议要经过后续状态整理和提交才成为持久记录。[专家的输入与输出](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/tools/src/modules/memory/advisory.ts#L169)
实际后端由 `memoryRuntime` 选择:Personalization 在回复前后调用外部 hooks,读写算法归 hook 服务;Axon Go 在 Harness 编排日记和表格读写,数据经 Axon 保存。`axon_shadow` 同时召回两边作比较,但实际返回与写入都用 Personalization,Go 不参与写入。Hinos 则在基础角色上下文渲染后请求外部 prepare,记忆非空时带回模板重渲染,回复后用同一 claim 提交正文;内部召回、整理算法不在此仓库。召回材料通过变量接入,模板未引用相应变量,就不能据“召回成功”认定 Actor 已看到。[hooks](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/memory/personalization-memory-runtime.ts#L36)、[shadow](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/memory/axon-memory-runtime.ts#L231)、[Hinos](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/memory/hinos-memory-runtime.ts#L165)
### 日记和记忆表怎样读写
**日记与记忆表是真正有读写过程的应用能力。** 在配置了 Axon Go 记忆的场景,回复前会召回已存日记摘要和表格内容,交给角色模板变量,模板引用时才进入本轮上下文;回复完成后,日记进入后台处理,表格则从模型原始输出中提取约定格式的编辑,再通过 Axon 更新。例如表格可以把“持有人:莉娅”改成“持有人:用户”,但普通正文里出现“借钥匙”并不等于代码一定会自动识别成这项编辑。表格带版本写入,发生冲突时会重读后重新应用一次编辑。[召回与写入](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/memory/axon-memory-runtime.ts#L98)
日记也不是回复完成就必写。后台先检查配置、订阅配额、冷却和锁,再向 Axon 询问本次是否应生成;只有计划返回允许,才读相应历史、请求摘要模型、解析并保存。代码中的 **20 / 10 是不同配置项缺失时的兜底值**:包括最小轮数、免费路径间隔,以及新版首次/后续间隔。它们能被配置覆盖,不能解释成所有用户统一每 20 或 10 轮启动 Planner。成功保存后,后续召回才可能使用这段摘要。[日记配置与生成判断](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/memory/diary-orchestrator.ts#L91)
### 用户偏好怎样进入
用户偏好还要分清“已配置的用户人设”和“聊天里新说的话”。已有用户人设由 Axon 变量准备过程提供,例如用户身份或背景;专家把它当用户资料,不自动当成角色已经经历过的事实。用户说“我不喜欢被叫小朋友”,会先进入聊天上下文;是否进入日记、记忆表或长期指令,取决于所选场景的保存链路,并没有统一的偏好字段抽取器替所有路径完成这件事。[用户人设进入本轮上下文](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/integrations/roleplay-axon-adapter.ts#L438)
### Compact 怎样保住长对话
**Compact 解决的是“历史太长装不下”。** 它在回复前读取此前的压缩检查点,验证摘要对应哪段历史,再按 token 预算决定是否继续压缩。较早对话变成结构化摘要,最近几组对话保留原文;摘要及覆盖范围以 checkpoint 保存,下次接着使用。历史被编辑、角色语义改变或无法证明前后连续时,旧检查点不能随便复用。所以它能帮助角色保留“钥匙借用约定”,却不是一份允许随意增删事实的导演状态;触发也看上下文容量与历史边界,不是固定每 X 轮。[Compact 的准备与检查点](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/memory/compact-runtime.ts#L888)
## 9. Story:世界推进、剧情计划与正文采用
**Story 是另一条业务分支,先准备这次可写的场面,再用实际保存的正文核实事情怎样发生。** 它替换普通 Agentic 规划包装,不是再往六位专家之后接一排工具。接入需要这条助手回复的消息 ID,因为后面必须核对“计划对应的那条正文”究竟保存了什么。重生成 `regenerate` 和编辑后重生成 `edit_regenerate` 在当前接线中直接使用基础 Actor,跳过 Story 准备与写入。[Story 接入及重生成分支](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/story/axon-adapter.ts#L30)
### 本轮准备世界与叙事
继续铜钥匙例子。第一轮还没有 Story 状态时,初始化器根据可见历史建立世界和叙事状态。此后两组工具分工合作:**World 管“现在在哪、发生什么、哪些内容能到达当前视角”;Narrative 管“这段故事想推进什么、铺垫兑现到哪了”。**
World 的 `PovPrepareTurn` 先判断玩家意图:继续当前事件、主动转向已存在的场外事件,还是回应上一轮实际送达的邀请。“把钥匙递给守卫”通常继续眼前场面,不能自行推断用户已进入塔内;需要转场且涉及同行角色时,才进一步判断同行或留下。程序在候选世界里推进时钟:前景按开始、发展、结束推进,后台事件倒计时,暗线按阶段与规则发展;到期事件会因当前阶段不同而延后、增加眼前麻烦,或接入下一场。数字、容量、阶段和视角约束由程序维护,模型补充具体事件内容,不能自由改计数。然后把本轮可用的场面投影交给 Actor;隐藏暗线不会整份倾倒为角色知识。[World 的玩家意图、准备与推进工具](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/tools/src/modules/story/world.ts#L85)
Narrative 的 `NarrativePlanCycle` 在需要新周期时由模型生成待推进目标,例如“让守卫验证钥匙来历”,同时保留未完成的目标和前置依赖。`NarrativeDealBeat` 则**不调用模型**:程序从满足前提的目标中,按优先级、主副线多久未推进、情绪方向和当前场面阶段派发节拍。它可以给 Actor 一条“逐步建立信任”的方向,不能把未来“获得通行许可”当成已发生。事件结束后的 `NarrativeSettleEvent` 才根据实际正文评估目标是否完成、主副线是否移动、情绪和用户方向;持续改变方向或副线长期停滞时,可由 `NarrativeRebranch` 重新设计相关线路。一次犹豫不等于自动推翻主线。[叙事计划、机械派发、结算与重分支](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/tools/src/modules/story/narrative.ts#L48)
Actor 最终收到场面投影和叙事节拍,仍保留原角色、语言和写作风格。例如“守卫站在侧门前,先回应交钥匙动作,可以逐渐露出巡逻异常”。它应让用户自己决定下一步;“可以铺垫追兵”不是“追兵已经到场”。
### 写完正文先保存待核对记录
假设 Actor 写出“守卫接过钥匙,却没有开门”。Harness 成功后,Story 的 `settle` 保存准备状态和 `pendingActor`:等待核对的助手消息 ID、关联用户输入、场面投影等。此时结果是 `waiting_for_acceptance`;**不是已经确认开门,也不是已经把这次正文的全部后果写进世界**。保存同样受版本检查约束;失败或冲突会记录在 Story 结果里,不能用“正文已经返回”推断 Story 也保存成功。[正文完成后保存待核对状态](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/story/coordinator.ts#L390)
### 下轮根据保存正文结算
下一次用户说“那我把钥匙拿回来”,Story 先读取上一条**权威保存的助手正文**,检查消息 ID、当时用户输入和此前已采用正文的内容锚点。匹配后,`PovAdvanceWorld` 根据“接过钥匙、未开门”推进世界,再处理这次“拿回来”。新的用户要求不会倒灌成上一轮的证据。这里的“采用”指实际保存的正文通过核对,不是等待用户点赞或点击确认。[下一请求核对并采用上一条正文](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/story/coordinator.ts#L190)
如果用户把尚待采用的最新回复改成“守卫拒绝接钥匙”,消息 ID 没变、关联锚点仍匹配,系统会采用该 ID 下实际保存的新正文结算。若修改的是关联用户输入或更早已经采用的正文,导致锚点不匹配,或者待采用消息缺失、换了 ID,才从当前权威历史重新建立 Story。事件结算所需的保存正文若缺失或变化,会经过有限重试和隔离记录,不会凭空补一个成功结局。上述下一轮准备得到的新世界仍先在内存里,等当前 Actor 成功并再次提交才持久化;当前轮失败,不能承诺推进已落库。
## 10. 世界书上线前:导入、修订、索引与会话绑定
**世界书先保存作者写好的资料,聊天时再从中选取。** 可以把一条条目理解为一张资料卡:正文写“北塔午夜后禁止开门”,旁边的字段写触发词、使用条件、优先级和插入位置。世界书服务管理这些资料,不负责生成角色回复,也不随聊天自动改写世界规则。
### 导入:先解析,再保存
资料可以通过原生创建接口保存,也可以从文件导入。导入器识别 JSON、PNG 中支持的世界书数据;遇到 CCv2/CCv3 角色卡,只提取里面的 `character_book`,角色资料不会随之变成角色管理记录。独立 `world_info` 也有对应解析入口。一次最多 5000 条。**预览只解析并返回条目与报告,真正保存需要后续创建或导入请求。**
导入报告很关键:这个服务接收的是可用于选择的静态内容子集。源文件里的脚本、EJS、前端组件、MVU、部分宏,以及 sticky/cooldown/delay 等运行时能力,并不会因为上传成功而在聊天里执行。导入器会识别相关要求、统计运行时受阻条目,并提示并非完整 SillyTavern 兼容。文件成功解析、条目成功保存、条目本轮有资格使用,是三个不同阶段。[导入与保存接口](https://github.com/FlowGPT/worldbook-service/blob/3a11e333afd335aeff165e0ccc3654af8e1897d1/src/worldbook/app.py#L178) · [导入限制、格式分支与报告](https://github.com/FlowGPT/worldbook-service/blob/3a11e333afd335aeff165e0ccc3654af8e1897d1/src/worldbook/importer.py#L108)
### 修订:发布新版本
保存后,PostgreSQL 留存书籍、原文条目和不可变版本。编辑一本书,是提交完整的新修订,并带上自己基于的 `expected_revision`;版本仍匹配才发布成功,否则返回版本冲突。比如《北塔设定》从第 1 版改成第 2 版,第 1 版仍然存在;正在使用它的会话也可以继续读到原来的设定。[修订发布](https://github.com/FlowGPT/worldbook-service/blob/3a11e333afd335aeff165e0ccc3654af8e1897d1/src/worldbook/repository.py#L276)
### 索引:让指定版本可做向量检索
向量索引是另一个显式步骤。调用索引接口后,服务按书籍、revision 和 embedding version 构建,状态经过 building,最后成为 ready 或 failed。已有 ready 索引且没有要求 force 时会复用。构建会切分原文、调用 embedding、把向量写入同一个 PostgreSQL 的 pgvector;它是可重建的派生资料,不是原文的替代品。这个请求同步完成构建,聊天每轮不会自动重新建索引。新版本已经保存,也不能据旧版本的 ready 状态认定新版本已经可向量检索。[索引构建与复用](https://github.com/FlowGPT/worldbook-service/blob/3a11e333afd335aeff165e0ccc3654af8e1897d1/src/worldbook/service.py#L150)
### 绑定:会话固定使用哪一版
最后,会话通过 pin 绑定 `book_id + revision`。当前 Demo 在创建会话时写入服务端配置的固定书籍版本;通用选择接口虽然能接收多本书,这个 Demo 只配置一本。作者发布第 2 版不会自动把第 1 版会话迁过去。Demo 若更换固定配置,旧会话的 pin 不匹配会被拒绝,不会静默改绑。角色设定仍由现有角色服务管理,世界书版本绑定也不代表角色 Prompt 被固定在同一版本。[创建会话与固定 pin](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/worldbook/debug-api.ts#L104)
## 11. 世界书每轮怎样选择:常驻、动态与必需
**每次用户输入都会重新计算本轮条目,不是累计 X 轮后才启动。** Harness 先取会话绑定的书籍版本和已保存状态,把“本轮输入+公开场景”作为 query,另带近期历史、状态条件、策略与预算。关键词默认扫描“历史+query”末尾 4 条消息,query 也占一条;这不是 4 轮。Harness 最多传 20 条 user/assistant 历史,不表示服务默认把 20 条全部扫描。条目还能覆盖自己的扫描深度。
### 先判断资格,再激活候选
选择先判断资格:是否启用、目标受众是否允许、状态条件是否满足、运行时要求能否支持、概率检查是否通过、正文替换后是否可用。**常驻和必需也过这一关。** 被禁用的 required 条目不会强行进入,也不会仅因“必需却被禁用”就在这里报错。
| 条目方式 | 通过资格检查后如何参选 | 放不下时 |
| --- | --- | --- |
| 必需 `required=true` | 免关键词,优先处理 | 已激活的必需包无法满足依赖、冲突或预算时,报错 |
| 可选常驻 `constant=true` | 免关键词,每轮直接参选 | 仍可因冲突、依赖或预算整包丢弃 |
| 动态 | 关键词命中、hybrid 排名候选、递归或显式依赖带入 | 整包取舍,不保证命中即入选 |
required 和 constant 是独立字段;同时为 true 时先按 required 处理。常驻的意思是“免关键词参与选择”,不是永久占据模型上下文。[原生条目字段与默认值](https://github.com/FlowGPT/worldbook-service/blob/3a11e333afd335aeff165e0ccc3654af8e1897d1/src/worldbook/models.py#L17)
### 动态入口:规则、混合召回与降级
动态条目有几条入口。关键词支持普通字符串、大小写/全词设置、正则和主次关键词逻辑;普通字符串默认不区分大小写,按子串匹配。rules 使用规则入口;hybrid 在规则之外,用当前 query 做词法和向量排名,合并后最多交给选择器 30 个候选。**hybrid 候选和显式依赖可以不命中关键词、也不通过次关键词逻辑,但不能绕过资格过滤。** 所以“没提北塔”不代表 hybrid 一定排除北塔;真正不得绕过的限制,应写成资格条件。
hybrid 的向量步骤遇到可识别的 `DomainError` 会返回降级信息,继续词法排名;rules 本就不依赖向量。这个回退不覆盖所有错误,必需包超预算、一般 RPC 失败等仍可能令本轮失败。[hybrid 排名、降级与预筛](https://github.com/FlowGPT/worldbook-service/blob/3a11e333afd335aeff165e0ccc3654af8e1897d1/src/worldbook/service.py#L67)
### 递归与显式依赖
条目还能带出其他条目。递归把已激活正文作为后续关键词材料,默认最多再扩展 2 次;原生 Entry 的 `prevent_recursion / exclude_recursion` 默认都是 true,而文件导入器对省略的这两个字段填 false。因此导入条目可能默认参与递归,要以保存后的字段为准。显式 `requires` 则把同一本、同一版本中的依赖连成一个包;依赖不需要自己命中关键词,但也必须有资格。递归激活发生在预算选择前,所以触发者最后被预算丢弃,不一定连带撤销它已触发的候选;依赖包才是成组保留约束。[文件导入的递归默认值](https://github.com/FlowGPT/worldbook-service/blob/3a11e333afd335aeff165e0ccc3654af8e1897d1/src/worldbook/importer.py#L186)
### 优先级和两种预算
最后按 required → 可选 constant → 动态争取预算;组内还比较 priority、直接关键词命中、hybrid 分数等。当前 Harness 场景给世界书 **2400 tokens**,服务自身默认是 1500。条目连依赖整包计数,包括包装与间隔,不把长正文截半;还受默认最多 50 条限制。默认 `constant_budget_ratio=0.35`,所以 2400 下,可选常驻候选发起的包,其累计新增成本上限是 **840 tokens**。这是上限,不是预留槽位;required 包不计入这笔常驻账,共享依赖不重复计费,也不能把它解释成“所有带 constant 标记的正文总和绝不能超过 840”。[资格、激活、依赖与预算实现](https://github.com/FlowGPT/worldbook-service/blob/3a11e333afd335aeff165e0ccc3654af8e1897d1/src/worldbook/selection.py#L123) · [当前场景的 hybrid/2400 配置](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/config/scenarios/agentic-v2-worldbook.json#L11)
## 12. 世界书怎样进入模型:一份实际材料示例
以下用虚构资料说明真实装配方式,不是线上请求或模型实测结果。会话绑定《北塔设定》第 1 版,用户说:**“我把铜钥匙递给北塔守卫,请他开门。”** 为了单独看清关键词,例子采用 rules;假设条目均通过资格检查、没有冲突、预算充足,近期窗口没提南港。
| 作者保存的正文 | 配置 | 本轮结果 |
| --- | --- | --- |
| 这个世界中,死亡不能被魔法逆转。 | constant=true | 常驻入口,入选 |
| 北塔午夜后禁止开门;只有摄政官的书面命令可以解除禁令。 | keys=[北塔] | 命中北塔,入选 |
| 铜钥匙证明持有人与旧王室有关,但不能代替摄政官的书面命令。 | keys=[铜钥匙] | 命中铜钥匙,入选 |
| 南港每周三有商船开往群岛。 | keys=[南港] | 未命中,不入选 |
### 实际加入模型的是条目正文
Actor 收到前三条的**正文**,不是整本书,也不是只有标题。条目正文可替换 `char / user`,随后 Harness 转义标签字符并包装。实际采用的形式如下,ID 是示意:
```xml
北塔午夜后禁止开门;只有摄政官的书面命令可以解除禁令。
```
默认将每条作为 system 消息放在人设前;作者也能配置人设后或 `at_depth`。depth 数的是装配中的消息块,不是用户轮数;0 表示尾部,后续还可能合并相邻同角色消息。入选内容在 Actor 开始生成前已装好,不需要 Actor 先主动调用世界书工具。
### 本轮重试与下一轮重选
同一逻辑轮的选择 Promise 会缓存,模型重试复用本轮结果;下次用户输入重新选择。临时条目不会因此写进正式聊天历史,也不会变成永久记忆。下一轮转去南港时,北塔仍可能留在最近扫描窗口内,所以“换话题”不等于“上一地点立即清空”。[本轮准备、缓存与消息装配](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/worldbook/runtime.ts#L22)
### Actor 与 Planner 分别收到什么
**同一轮有两份独立模型输入。** 下表描述材料来源,省略各自模板、裁剪和消息合并,不代表两个请求共用同一套 Prompt:
| 材料 | Actor:生成当前角色回复 | Planner:后台分析与规划 |
| --- | --- | --- |
| 角色、用户输入、既有历史、旧状态 | 按前台模板组织和投影 | 按分析模板重新组织,窗口与投影可不同 |
| 本轮入选的北塔与铜钥匙原文 | 直接收到上述条目消息 | 没有直接收到本次世界书结果 |
| 本轮 Actor 新回复 | 正在生成 | 并行分析时没有收到 |
世界书准备发生在 Actor 调用前,Planner 不负责决定这次是否召回。Actor 生成与普通 Agentic 后台规划可以并行;后台产出的新状态还要经过相应验证、版本与提交流程,成功保存后才供后续轮次读取。[Actor 前准备](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/runtime.ts#L338) · [Planner 独立历史来源及上下文](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/runtime.ts#L402)
因此 Actor 可能让守卫说“没有手令不能开门”,Planner 却未必掌握世界书里这条限制。若规则已经存在于它收到的人设、旧状态或历史,它仍可能知道;只是没有自动共享本次原文。把条目 audience 多写一个 planner,也不会自动建立转发链路。如果角色把规则说进了最终回复,宿主保存后、未来又将它带回且保留在 Planner 窗口内,规则才可能经普通对话间接传递。模型看到了资料,也不等于保证逐条遵守。
### 完整 Prompt 还要再过预算
世界书自身的 2400 预算只是一道筛选。完整 Actor 输入还包含人设、历史等,Harness 会检查模型上下文,扣除输出额度和安全余量;worldbook 场景即使没有 Compact,也会开启这项检查,默认安全余量为 1000 tokens。整体仍放不下会报超限,不能靠“世界书选择成功”推断模型请求必然成功。[世界书启用完整预算](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/integrations/roleplay-axon-adapter.ts#L556) · [Actor 整体计数与超限处理](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/actor/roleplay-runtime.ts#L842)
## 13. 世界书页面里,作者、管理员和用户分别控制什么
**当前聊天 Demo 是固定世界书的浏览与使用页面,通用服务则提供资料管理 API。** 二者的能力不同。下面按工作分工介绍控制点;“作者”“管理员”是便于理解的职责称呼,代码并没有据此提供一套完整的组织角色权限系统。
| 控制点 | 由谁准备或决定 | 当前实际能力 |
| --- | --- | --- |
| 世界资料 | 内容作者;由管理程序提交 | 编写正文,设置关键词、常驻/必需、条件、受众、概率、优先级、依赖和位置 |
| 资料版本与索引 | 管理员或后端接入程序 | 调创建/导入/修订/索引 API;预览不会保存 |
| 会话可用哪本书 | 服务端配置与创建会话后端 | Demo 固定 book_id+revision,并写入会话 pin |
| 本轮选谁 | 世界书服务 | 根据当前输入、历史、状态和规则计算;界面点开某条不会强制选中 |
| 入选原文放哪里 | 作者的位置字段与 Harness 装配 | 人设前、人设后或指定消息深度 |
| 看完材料怎样说话 | Actor | 结合整份输入生成当前回复 |
### 聊天用户能操作什么
用户可以从配置列表选角色、发送消息,浏览固定世界书、搜索标题/关键词/正文并查看参数。页面搜索只是筛选展示列表,不会把搜索框内容当作下一轮检索 query。用户无法勾选若干条来强制本轮注入,也不能在当前聊天页调整 strategy 或 tokenBudget;后者来自服务端场景配置。[界面列表搜索](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/worldbook/web/src/main.tsx#L140)
当前 Demo 也没有开放导入、编辑、发布修订、建索引或切换书籍。它只允许读取固定版本的书、条目与索引状态,其他管理请求被拒绝。这不影响 Worldbook Service 本身拥有管理 API。作者写好资料后,仍由能访问那些 API 的管理程序完成发布;在聊天页面打开条目详情只是查看。[Demo 固定范围与只读方法](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/worldbook/demo-config.ts#L23)
### 怎样查看实际注入结果
页面的“本轮世界书”用于解释这次装了什么:可以看到入选正文、ID/版本、位置、选择理由和筛选决策。快照在首次 Actor 装配时通过 SSE 返回。它能解释选择结果,但不是完整模型输入日志,也不能证明角色遵守了每条资料。快照留在浏览器工作区,服务端历史保存的是对话正文,不会补存整份世界书 trace;换浏览器或清缓存后,不能依靠历史接口恢复全部旧快照。“没有快照记录”和“这轮确实选中零条”需要分开看。[页面 API、场景设置与 trace/正文分流](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/worldbook/debug-api.ts#L93)
### 设定、状态与权限分别归谁
资料内容也有不同归属。“铜钥匙代表旧王室身份”适合写作稳定世界背景;“钥匙刚交给守卫”是这一局已经发生的变化,应由对话和状态承载;“接下来可以检查钥匙真伪”属于规划建议。世界书服务不会在聊天后自动把三者整理、回写成新的书籍版本,也不管理角色 Prompt。
服务端还有一个需要分清的访问概念:普通 Worldbook 接口使用服务配置的 tenant;当前应用层不检查 Bearer,另有只读的跨租户管理浏览入口。因此这里介绍的“管理员能调用管理 API”是接口能力,不代表某个登录角色已经获得正式授权。实际部署的访问限制由外层入口、Axon 或网关等接入安排决定,不能仅从 Demo 的页面菜单推断。[普通接口的 tenant 来源](https://github.com/FlowGPT/worldbook-service/blob/3a11e333afd335aeff165e0ccc3654af8e1897d1/src/worldbook/app.py#L32) · [管理浏览入口](https://github.com/FlowGPT/worldbook-service/blob/3a11e333afd335aeff165e0ccc3654af8e1897d1/src/worldbook/app.py#L299)
## 14. 工具:怎样被模型选中,怎样执行和保存
工具不会因为安装在仓库里就被模型自动发现。接入方先提供一份本场景可用的工具清单,包括名字、用途、参数格式和真正执行的代码;模型只在这份清单里选择。通用慢执行先把用户输入、起始状态、历史和工具说明交给协调模型。模型可以直接给结论,也可以返回“调用哪个工具、参数是什么”。程序检查工具名、整批参数和调用数量,合法后才执行;同批可并行,存在前后依赖的工作要分到下一步。[慢循环的注册与执行](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/sdk/src/slow-runtime.ts#L32)
Registry 可以按 Schema 校验参数,通用 Slow 已开启;基础 Registry 默认不开启。`readOnly`、`advisory` 等声明不自动提供授权、确认或事务。例如两个工具并行执行,一项写入成功、另一项失败,成功写入不会自动撤销;外部接口仍由执行代码核验用户范围与操作权限。[校验开关与执行边界](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/sdk/src/registry.ts#L38)
### 模型选工具后,程序做什么
例如用户问“守卫怎么知道我拿了钥匙?”协调模型可以选择知识专家,提供“检查守卫知情依据”的原因。专家读取现有状态与可见对话,发现只有莉娅知道借钥匙的事,返回“守卫目前没有已建立的知情来源”。程序把这份结果交回协调模型,模型再决定是否继续分析或结束。工具自身也可能调用另一个模型,因此一次“工具调用”不一定只是一次数据库查询;工具数量与模型请求数量是两种统计。
### 建议、当轮材料和持久写入
**分析结果和保存结果分两步。** 普通 Agentic 的专家只提建议,导演工具负责整理完整候选状态。应用检查格式、长度和内容是否变化,再带着原版本提交;如果另一轮已经写入更新状态,旧候选会被拒绝,避免把新进展覆盖掉。成功后,后续轮次重新读取时才能看到;已经开始生成的本轮正文不会被后台改写。比如“守卫还不知道钥匙归属”可以成为后续连续性约束,但专家说完这句话并不等于状态已保存。[候选检查与状态提交](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/agentic-v2.ts#L968)
也有工具结果直接影响当前回复。应用可以把工具返回的一段文字投影到本轮 Prompt 的指定位置,例如先查到“桥已封闭”,再让 Actor 写抵达桥头的反应。这条机制要由场景接好;它和普通 Agentic 后台保存状态是不同用法。返回数据不一定要进 Prompt,纯图片资产、诊断或保存回执也可以只供程序处理。[工具结果进入当轮 Prompt](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/prompt/compiler.ts#L33)
### JSON 记忆与执行回调
另一个可单独复用的工具是 JSON 记忆读写。读取返回内容和版本,更新接收完整新对象及预期版本,由宿主绑定的存储保存。它是整对象替换:新对象没带的字段会被删除。它不会自动接管 Emochi 的日记、表格或导演状态,也不会由模型自由指定其他用户的存储范围。[JSON 记忆工具](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/tools/src/memory-tool.ts#L14)
工具还可以有执行前后处理:执行前校验或补充资料,执行后记录结果,整轮结束后做汇总。但整轮结束回调需要宿主主动调用;外部写已经成功后,记录日志失败仍可能让工具报错,不能据此重新执行同一笔写入。模型选择、程序执行、业务成功、持久化完成是四个具体步骤,失败要落在相应步骤上处理。[工具生命周期](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/tools/src/tool.ts#L10)
## 15. 图片、长期指令与Sumi各自怎样运行
在启用前台工具控制器的 Emochi 场景,一次回复可以分成“写一段 → 安排一张图 → 再写下一段”。控制模型读取用户本次需求,选择调用 Actor 或其他已开放工具;Actor 负责真正的角色正文,控制模型再根据刚完成的段落和剩余正文预算决定下一步。例如“写我们进入北塔的过程,并配两张图”,可以先写门外场景、安排插图,再继续室内段落。所有 Actor 段落共用本轮正文预算,不是每调用一次就得到一份新额度。[前台编排与共享预算](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/actor/roleplay-runtime.ts#L329)
### 图片如何补到当前消息
**图片能在后台完成,却补回本轮消息。** 调度图片后,前台可以继续输出文字;图片任务根据对应段落和角色视觉资料准备生成内容,等待这条 assistant 消息已经保存,再写入图片位置、待生成状态和图片提示词,随后请求图片服务。结果归属于这条消息的图片区域,不需要等用户发下一句话。因此用户可能先看见正文与占位,稍后在同一条回复里看到图片。这里保存的是消息的图片结构与任务结果,和后台导演维护剧情状态不是同一项写入。[同一条消息的图片写入](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/tools/imagine-skill.ts#L321)
### DIO 怎样改变后续角色表现
长期指令走另一条路。例如用户明确要求“以后让莉娅说话简短一些,保留这种风格”,具备 DIO 工具的场景可以把原始要求交给外部 Director 服务,连同用户、RP 会话和目标角色身份一起提交。返回 accepted 只表示任务已接收;后台继续观察最终结果。后续请求读取有效的编译 Prompt,并应用到约定的角色指令位置。正在生成的这一轮不会被半途换 Prompt,也不能把普通“继续故事”或仅本轮的临时要求都当成长期修改。长期版本及编译结果由 DIO 服务管理,Harness 保存的是接入身份并读取其结果。[长期指令的接收与后续读取](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/tools/dio-skill.ts#L70)
### Sumi 的逐轮图文状态
**Sumi 是独立的图文 RP 路径。** 首次遇到一组角色、人设、开场白和参考图时,它用视觉模型提取初始人物、场景、风格等状态,并缓存结果。后续每轮读取对应历史消息的快照,把上一份状态与聊天记录送给主模型。模型输出经过解析,拆成用户可见正文、内部状态与图片描述;前台只展示可见内容,结束后保存本轮前后状态、模型文本、正文和图片列表,再安排图片交付。[Sumi 的初始化与逐轮处理](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/sumi/runtime.ts#L64)
例如第二轮出现“莉娅脱下斗篷”,Sumi 后续使用的状态来自对应消息快照,而不是普通 Agentic 的六专家与导演链。它还检查人物材料和分支连续性,避免把另一个角色或另一条分支的状态接进来。快照经 Axon 的状态接口按用户、会话、角色及逻辑记录键隔离保存。当前配置不允许把 Sumi 与普通 Agentic、Compact、Emochi 记忆 hooks 随意叠加;选择 Sumi 就是在选择这套独立运行方式。[Sumi 状态的存储范围](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/sumi/store.ts#L35)
## 16. 取消、重试与失败:用户最终会看到什么
**一轮 RP 包含多项工作,它们可能分别成功或失败。** 用户看到了文字,只能先确认正文已产生;日记、剧情状态、图片和长期指令还各有自己的完成状态。
### 按失败发生的位置看结果
| 发生的事情 | 当前链路如何处理 | 用户侧可能出现的结果 |
| --- | --- | --- |
| 世界书 hybrid 的向量索引未就绪或向量不可用 | 记录降级原因,继续词法召回 | 仍可回复,但选择结果可能变化 |
| 绑定了世界书,选择 RPC 发生其他错误 | 当前 Harness 不统一吞掉错误 | 当轮回复可能无法开始 |
| 闭环记忆召回失败 | 该入口设置为 fail_turn | 正文准备失败 |
| 回复前所需角色/模板准备失败 | 发生在生成启动之前 | 即使出问题的是后台所需模板,也可能挡住正文 |
| 普通 Agentic 后台模型失败 | 返回失败报告,保留相应旧状态 | Actor 可能正常回复,持续状态没有更新 |
| Director 候选没有变化或未通过校验 | 不提交新状态 | 后台工作做了,但状态仍旧 |
| 状态 CAS 版本冲突 | 拒绝这次旧候选覆盖较新状态 | 不等于重新规划或自动合并成功 |
| Story 本轮候选保存失败 | settle 报告失败;正文结果与该报告分开 | 正文成功,世界/剧情候选可能未保存 |
| 完成后的记忆 ingest 失败 | 该闭环入口采用 best_effort | 文字可能已交付,记忆更新失败 |
| 完整模型输入超预算 | 检查后拒绝该模型请求 | 世界书选成功,也可能还不能开始生成 |
### 用户点“停止”时
普通 Actor 的生成会收到取消信号,但普通 Agentic 后台调度没有绑定同一个 Actor 父信号,已经启动的后台仍可能尝试保存状态。已经发出的外部写入也不会因为停止输出被自动回滚。
通用 SDK FastSlow 的显式 `cancel` 会向两路传递取消信号,是否停止仍需要底层模型和工具配合。外层不再等待,不代表忽略信号的外部任务已经停止。如果一个写工具已经保存成功,随后网络响应丢失,看到的失败并不能证明“什么也没发生”。图片、记忆等写入需要按各自结果与去重机制处理,不能一律重新执行。
**快路失败和显式取消也有区别。** SDK 中快模型请求失败,不会自动取消已安排的慢路;只要慢路继续完成,且接入方配置的 `prepareCommit` 返回候选,它仍可尝试保存。若产品要求“只有正文已被采用,状态才能更新”,接入方要把这一条件放进接受与提交流程,不能仅凭两路属于同一轮来推断。[SDK 两路调度与取消](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/sdk/src/runtime.ts#L60)、[独立提交回调](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/sdk/src/slow-runtime.ts#L137)
### 编辑、重新生成和连续快速发送
Story 的 regenerate/edit_regenerate 会退回原 Actor,只生成替代文字,不执行 Story 状态写入。正常新轮会核对已保存正文及锚点:最新待采用回复仍为同一消息 ID、相关锚点匹配时,可以采用其编辑后保存的正文;关联用户输入或更早已采用正文被改、锚点失配,或者待采用消息缺失、换 ID,才重建 Story。
用户连续快速发送两句时,下一轮可能在上一轮后台保存前读取旧状态。版本检查可以拒绝过期覆盖,但不会让已经准备好的 Actor 自动换上后来才保存的新笔记。
当前后台 runner 用内存中的 Promise 集合跟踪任务,关闭时可以等待、取消;它自身没有任务数据库和进程崩溃后的续跑功能。Sumi 等具体应用对部分图片任务另做了持久声明和去重,不应把某条应用的保障推广给所有工具。
依据:[入口失败策略](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/adapters/agent-router/dispatch.ts#L719)、[后台独立调度](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/runtime.ts#L558)、[Story 保存报告](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/story/coordinator.ts#L419)、[重生成路径](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/story/axon-adapter.ts#L34)、[后台任务生命周期](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/sdk/src/tasks.ts#L15)。
## 17. 调用成本、时间与可观察结果
**一条用户消息可能触发多次模型调用。快慢并行改变等待方式,不会把后台推理变成零成本。**
### 一轮到底调用几次模型
以普通 Agentic 为例,假设 Actor 一次成功,后台调用两位专家,然后协调器决定让 Director 整理状态,而且没有重试:
| 工作 | 这个例子中的调用数 |
| --- | ---: |
| Actor 写正文 | 1 |
| 后台协调器第一次选专家 | 1 |
| 两位专家分别分析 | 2 |
| 后台协调器再决定是否整理状态 | 1 |
| Director 生成候选状态 | 1 |
| 合计 | 6 |
这是按所述分支计算的示例,不是所有轮次固定六次。后台可以不调用专家;配置升级模型、失败重试、前台分段、Compact、日记或图片又会增加工作。世界书选择不是一次聊天 LLM 调用,但 hybrid 的 query embedding 可能产生另一次向量模型请求。
### 不同数字分别限制什么
| 设置/数字 | 作用范围 |
| --- | --- |
| 普通 Agentic 每逻辑轮调度 | 后台启动频率;没有全局 X 轮参数 |
| 世界书 2400 tokens | 当前场景世界书内容预算,不含整份角色与历史 |
| 世界书 scan_depth=4 | 关键词扫描的消息项数,含 query |
| Planner 近期 transcript=9 | 内置近期历史段的消息数 |
| SDK Slow 默认 maxSteps=4、maxToolCalls=8、maxParallelTools=4 | 通用慢执行内部循环、工具数量与并发限制;不是 Emochi 所有场景的共同默认值 |
| SDK Slow 默认 timeoutMs=180000 | 该慢执行的超时;快路另有超时控制 |
| Actor/Planner 状态文本长度 | 这一部分材料的字符裁剪,与 token/cost 限制不同 |
SDK 的 token/cost 限制根据已经返回的 usage 在调用前后检查,没有为每个并行调用预扣额度。因此已发出的调用可能使累计量跨过上限,然后阻止后续执行;它不是整个产品的统一扣费闸门。
### 页面和日志能证明什么
世界书快照可以回答“本轮装入了哪条原文、为何入选、预算是多少”;它不能证明角色遵守了设定。正文完成事件也不能单独证明后台状态保存成功。要查状态更新,需看对应提交结果和 revision,不能只看回合结果里递增的 stateVersion。
SDK 提供可选 Trace/Langfuse 接口,但实际应用要在调用、工具、状态边界接入;默认不采集输入输出正文。当前 Demo 的世界书快照经 SSE 回到浏览器,服务器聊天历史不单独保存这份快照;清理浏览器后可能失去它。
仓库已有评估器可检查指定事实是否出现在输出、禁止文本是否出现。该通用评分器使用规范化文本匹配,适合特定回归用例;完整剧情合理性还不能由这一个分数代表。报告的 passRate 分母是完成且有评分的样本,失败样本另外列出,阅读结果时要同时看完成数。
依据:[后台执行阶段](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/agentic-v2.ts#L803)、[SDK 限制默认值](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/sdk/src/runtime-shared.ts#L118)、[用量检查](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/sdk/src/slow-runtime.ts#L235)、[Trace 内容采集](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/sdk/src/telemetry.ts#L52)、[评分实现](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/evaluations/scorer.ts#L12)、[评估汇总](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/evaluations/runner.ts#L20)。
## 18. 已有业务怎样接入SDK和Workflow
接入可以从一个工具开始,不必一次替换整个聊天系统。**单独工具**适合已有稳定链路、只想增加一项能力的业务:例如原来的回复前增加知识检查,业务传入角色、历史、状态与模型,拿到建议后决定放进当前上下文还是留作记录。要读写数据,就给工具绑定自己的存储与用户范围。**通用 Agent**则适合自己定义模型与工具对话过程:业务准备消息和工具,Agent 每次建立一个新的模型代理执行,完成后由业务解释返回结果;它不替业务加载角色库、保存聊天或安排后台任务。[通用 Agent 的职责](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/sdk/src/agent.ts#L9)
### 单独做一次慢分析
**独立 Slow**适合“做完一整次分析再交回”的任务。比如用户已接受一段剧情,业务把这段正文、历史和起始状态交给慢执行;它完成模型与工具循环,返回结论和工具结果。业务可以只展示分析,也可以经接受后提交状态;若配置提交回调,SDK 会用预期版本调用存储。Slow 自己不负责后台调度,也不会自动重新从聊天数据库找输入。[独立慢执行](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/sdk/src/slow-runtime.ts#L25)
### 把已有 Workflow 接成快路
**FastSlow**适合“当前回复与下一步规划并行”的交互。入口先读一次状态并冻结本轮快照,再安排慢任务与快生成;默认快路只有一次模型请求。如果业务原来已有“识别意图 → 查资料 → Writer”的 Workflow,可以把整条链包装成快路的 `complete`,需要流式就再实现 `stream`。SDK 不会自动发现旧 Workflow,也不会替它拆节点。两路共享起始材料,慢路看不到本轮刚写出的回复;每调用一次组合入口就安排一次慢执行。想每三轮分析,业务就按自己的计数规则调用独立 Slow,而不是找一个内置的 X 开关。[默认快路与自定义快路](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/packages/sdk/src/runtime.ts#L48)
### 复用现有应用服务
**直接接业务服务**是另一种选择:沿用 Harness 请求接口、场景配置和 Axon 等现有服务,得到已实现的 Emochi 或 Sumi 行为。这比接一个工具包含更多产品规则,也带来现有场景的组合限制。Emochi 实际使用自己的 Planner、协调器和适配器;安装 SDK 不会自动安装这套应用配置。比如要复用现有日记和角色渲染,接业务服务与只调用 FastSlow 是两项不同工程。[应用服务的装配](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/adapters/agent-router/dispatch.ts#L1125)
### 需要可恢复任务时怎样包装
若已有持久 Workflow,推荐把一次分析显式包成平台步骤:先保存任务 ID、输入快照和配置版本;步骤执行时重建模型与工具依赖,完整等待 Slow 返回;检查成功、失败或超时,再由独立提交步骤核对版本并保存接受结果。例如“总结第 30 轮已保存正文”重试时仍使用同一份输入,已接受的结果也有去重记录。只在步骤里启动 FastSlow 的后台 Promise 就返回,并不能让平台恢复这个脱离步骤的工作。Slow 内部每次模型调用也不是自动检查点,重新执行分析可能重新推理;持久化、排队和步骤重试仍由 Workflow 平台承担。[Workflow 的显式包装示例](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/docs/sdk/examples/08-workflow-step.md#L7)
## 19. 两轮完整演示:这些模块接起来后怎样工作
**以下是一段虚构 RP,用来逐步说明当前世界书 + 普通 Agentic 场景。时间用阶段表示,不是实测耗时;回复与状态内容都是示例。**
### 开始之前,系统已经有什么
| 对象 | 示例内容 |
| --- | --- |
| 角色卡 | 北塔守卫谨慎、忠于职责,对旧王室有复杂情绪 |
| 会话绑定 | 《北塔设定》revision 1 |
| 世界书门禁条目 | 午夜后开门必须有摄政官手令 |
| 世界书钥匙条目 | 铜钥匙证明旧王室关联,但不能代替手令 |
| 原对话 | 用户刚走到北塔门外 |
| 已保存状态 revision 12 | 午夜,守卫当值;用户与守卫尚未建立信任 |
### 第 N 轮:用户说“我把铜钥匙递给守卫,请他开门”
**准备阶段。** 入口选定世界书场景,读取书籍 pin、人设、历史和 revision 12 的状态。Harness 用这句话与公开场景构造 query,世界书服务按当前 hybrid 设置计算候选,再通过资格、依赖、冲突与预算选择。本例假设门禁和钥匙条目都入选。
**两份材料形成。** Actor 的包包含门禁与钥匙原文;后台包包含角色定义、用户输入、可用近期历史与起始状态,没有直接复制这两条入选原文。即使两边叫同一个模型服务,也仍是两次独立输入。
**开始并行。** Actor 可能回复:“守卫没有接钥匙,压低声音:身份我认得,但没有手令,今晚谁都不能进去。”后台协调器可能同时找 NPC 专家分析动机、找伏笔专家分析钥匙今后的作用。后台此时不知道 Actor 刚写了“没有接钥匙”。
**各自完成。** Demo 保存用户消息与最终角色正文。后台如调用 Director,会得到完整候选,再检查格式、变化和 revision;假设允许保存,就把候选与相应专家记录提交为新的状态 revision。没有通过检查或版本已变,则本次不覆盖。
这轮世界书条目只临时进入 Actor 输入。它们没有因为这次注入就整段复制到聊天记录、普通 Agentic 状态或长期日记。后台写出的分析也不能凭空被当作“守卫已经收下钥匙”的事实。
### 第 N+1 轮:用户说“那我去找摄政官”
如果后台已经提交成功,这轮准备时可以读到新状态;如果它还没完成,就仍可能读到 revision 12。历史中已保存的守卫拒绝现在才有机会进入后台可见窗口,使其知道“守卫没有接钥匙、要求手令”。
世界书重新选择。用户没再说北塔,不代表北塔条目立即消失,因为近期历史仍可能命中;摄政官相关条目也可能因关键词或混合召回进入。上一轮世界书快照不会简单当永久追加材料一路累积。
Actor 用这轮实际准备好的材料续写。它不会在生成一半时自动切换到后来才写成功的后台状态。
### 其他模块放到哪里
当前这份世界书场景配置没有启用日记 sources 和 Compact,所以本例没有悄悄执行这两项。其他有效场景启用记忆时,召回在正文前提供材料,更新在正文后按相应规则进行;启用 Compact 时,必要的压缩也在本轮正文之前完成。
如果采用 Story,则换成 Story 那条流程:下一轮核对上一轮实际保存的正文,再形成世界与叙事候选;当前 Actor 成功后一起保存候选与新的 pending。现有世界书专用场景不能直接把 Story 再叠上去。
这就是当前“合在一起”的含义:业务先选择有效组合,每个模块在确定的位置处理确定的材料。工具目录里有十种能力,并不意味着这十种在每一轮都会执行。
依据:[世界书请求与临时消息](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/worldbook/runtime.ts#L39)、[开轮状态与后台输入](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/runtime.ts#L338)、[候选状态提交](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/planning/agentic-v2.ts#L968)、[Demo 保存正文](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/apps/emochi/worldbook/debug-api.ts#L149)、[本例场景设置](https://github.com/FlowGPT/roleplay-harness/blob/80aef3fa5582d8508ecdd1afa206391940ce9502/config/scenarios/agentic-v2-worldbook.json#L1)。
补充阅读与核验范围
正文覆盖两仓库与 RP 有关的执行入口、应用组合、上下文、快慢执行、记忆、Story、世界书生命周期、工具、图文、持久化、失败与 SDK 接入。依据来自实现、配置、文档及测试断言;本次修改没有运行付费模型、修改业务实现或验证线上部署。
需要核对更细的实现时,可阅读[上下文对照](rp-context-audit.md)、[工具与模块说明](rp-modules-audit.md)、[SDK 接入说明](rp-sdk-audit.md)、[世界书注入拆解](worldbook-input-walkthrough.md)、[世界书选择细则](worldbook-selection-notes.md)和[补充代码核验记录](rp-project-coverage-audit.md)。这些是正文的依据和补充,主流程已在前面各章展开。